Έργο Οκτώβριος 2026
Ο AI βοηθός πίσω από αυτό το site
Ένας δίγλωσσος βοηθός, στα ελληνικά και τα αγγλικά, που συνδυάζει decision models, υβριδική αναζήτηση και απαντήσεις με παραπομπές για τη δουλειά, την έρευνα και τα άρθρα μου, όπως αυτά για τη Formula 1.
Λεπτομέρειες έργου
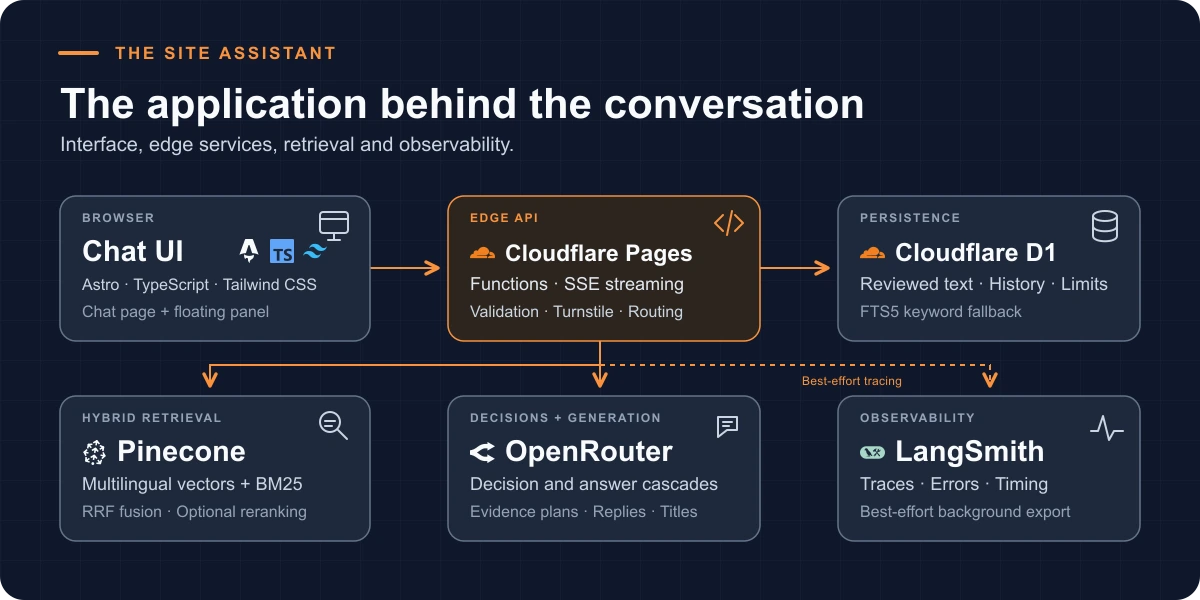
Ο βοηθός του site είναι μια δίγλωσση εφαρμογή RAG (retrieval-augmented generation). Απαντά σε ερωτήσεις για τη δουλειά, την έρευνα και τα άρθρα μου, αναζητώντας πληροφορίες στις σελίδες του site, σε PDF και σε παρουσιάσεις.
Η διαδικασία χωρίζεται σε τρία στάδια: ταξινόμηση του αιτήματος, αναζήτηση πηγών και σύνθεση της απάντησης. Τα decision models επιλέγουν πώς θα χειριστεί το σύστημα την ερώτηση. Ένας planner καθορίζει ποιες πηγές χρειάζονται και ένας writer γράφει την απάντηση με βάση τα αποσπάσματα που βρέθηκαν. Η Cloudflare φιλοξενεί την εφαρμογή και τα δεδομένα της, η Pinecone αναλαμβάνει την υβριδική αναζήτηση και οι κλήσεις στα μοντέλα περνούν από το OpenRouter.
Οι δυνατότητες των μοντέλων είναι συγκεκριμένες. Μπορούν να ζητήσουν πληροφορίες από τις διαθέσιμες πηγές, επιστρέφοντας ένα αίτημα με προκαθορισμένη δομή. Δεν έχουν πρόσβαση σε εκτέλεση κώδικα, SQL queries ή ελεύθερη περιήγηση στο web.
Αρχιτεκτονική
- 01Έλεγχος αιτήματος
Συγκατάθεση για cookies, πρόσβαση στη συνομιλία, Turnstile και rate limits.
- 02Έλεγχος cache
Χρήση αποθηκευμένης απάντησης, όταν υπάρχει.
- 03Πώς θα απαντήσει
Απάντηση με πηγές, χαιρετισμός, διευκρίνιση ή άρνηση.
Απάντηση με πηγές
- Επιλογή πηγώνΣτοχευμένες αναζητήσεις και έλεγχος των πηγών, μαζί με όσες επιλέχθηκαν με @.
- Ανάκτηση και κατάταξηPinecone semantic + BM25 → RRF → προαιρετικός reranker.
- Κείμενο από την D1Τα IDs των αποτελεσμάτων οδηγούν στο αποθηκευμένο κείμενο των πηγών.
- Σύνθεση απάντησηςΜε βάση τις πηγές, στην επιλεγμένη γλώσσα και persona.
Χωρίς αναζήτηση πηγών
Ο βοηθός χαιρετά, ζητά διευκρίνιση ή εξηγεί γιατί δεν μπορεί να απαντήσει.
Δεν χρειάζεται ανάκτηση κειμένου για αυτή την απάντηση.
Το κείμενο εμφανίζεται σταδιακά μέσω SSE. Η τελική απάντηση συνοδεύεται από παραπομπές και το μοντέλο που τη συνέθεσε.
Ο τίτλος δημιουργείται ανεξάρτητα και το tracing στο LangSmith γίνεται σε best-effort βάση. Οι απαντήσεις από την cache περνούν από τους ίδιους ελέγχους και την ίδια διαδικασία αποθήκευσης.
Το αίτημα φτάνει σε μια Cloudflare Pages Function. Πριν ξεκινήσει η επεξεργασία, ελέγχονται η συγκατάθεση για cookies, η πρόσβαση στη συγκεκριμένη συνομιλία, το Turnstile και τα rate limits. Η διαθέσιμη χρήση δεσμεύεται με atomic operation στη βάση, ώστε παράλληλα αιτήματα να μην παρακάμπτουν τα όρια. Κάθε συνομιλία και μήνυμα έχει σταθερό ID. Έτσι εξασφαλίζεται το idempotency: αν υποβληθεί ξανά το ίδιο αίτημα, το σύστημα αναγνωρίζει το υπάρχον μήνυμα αντί να δημιουργήσει δεύτερο.
Η cache ερωτήσεων επιτρέπει την επαναχρησιμοποίηση αποθηκευμένων απαντήσεων, χωρίς νέα κλήση σε μοντέλο. Οι απαντήσεις από την cache περνούν από τους ίδιους ελέγχους και την ίδια διαδικασία αποθήκευσης με τις υπόλοιπες. Αν η cache δεν είναι διαθέσιμη, η ερώτηση ακολουθεί την κανονική ροή.
Το decision model κρίνει αν χρειάζεται απάντηση με πηγές, ένας απλός χαιρετισμός, διευκρίνιση ή άρνηση. Μαζί με την επιλογή επιστρέφει τις πιθανότητες για κάθε κατηγορία. Ο server ελέγχει αν η κατανομή είναι έγκυρη, πόσο υψηλή είναι η πιθανότητα της πρώτης επιλογής και πόσο απέχει από τη δεύτερη. Αν η απόφαση δεν είναι αρκετά σαφής, δοκιμάζεται το επόμενο μοντέλο. Αν η ασάφεια παραμένει, ο βοηθός ζητά διευκρίνιση. Αν δεν λειτουργεί κανένα decision model, η διαδικασία σταματά χωρίς να παραχθεί απάντηση.
Όταν η ερώτηση χρειάζεται πηγές, ο planner παίρνει έναν κατάλογο με τίτλους, URLs και metadata εγγράφων. Επιστρέφει τις αναζητήσεις που θέλει να γίνουν και τις πηγές που προτείνει να χρησιμοποιηθούν. Ο server ελέγχει το πλάνο και έπειτα ανακτά το κείμενο. Ο κατάλογος χρησιμεύει στην επιλογή πηγών· οι πληροφορίες του δεν αρκούν από μόνες τους για να στηρίξουν την απάντηση.
Ο writer παίρνει τα αποσπάσματα που βρέθηκαν, τα IDs των παραπομπών, τη γλώσσα και την persona. Το ιστορικό τον βοηθά να καταλάβει σε τι αναφέρεται μια επόμενη ερώτηση, αλλά δεν υποκαθιστά τις πηγές. Η δομή της απάντησης διαφέρει ανάλογα με το αν πρόκειται για πληροφορία, χαιρετισμό, διευκρίνιση ή άρνηση. Όταν η απάντηση δίνει πληροφορίες για το περιεχόμενο του site, οι παραπομπές είναι υποχρεωτικές.
Technology Stack
| Επίπεδο | Υλοποίηση |
|---|---|
| Frontend | Astro, TypeScript και Tailwind CSS, με κοινό client για τη σελίδα chat και το panel του chat. |
| Backend | Cloudflare Pages Functions, διαχείριση HTTP αιτημάτων και server-sent events (SSE). |
| Αποθήκευση | Cloudflare D1 για το κείμενο αναφοράς των πηγών, την κατάσταση των συνομιλιών, τα δικαιώματα πρόσβασης, τις cached απαντήσεις και τους μετρητές χρήσης. Το FTS5 αναλαμβάνει την αναζήτηση λέξεων-κλειδιών όταν χρειαστεί fallback. |
| Υβριδική αναζήτηση | Pinecone Documents API, ενσωματωμένα multilingual-e5-large embeddings και αναζήτηση πλήρους κειμένου με BM25. |
| Κατάταξη | Reciprocal rank fusion (RRF) και προαιρετικό reranking με bge-reranker-v2-m3. |
| Model inference | OpenRouter, με ανεξάρτητες αλυσίδες για decision models και chat models. |
| Προετοιμασία περιεχομένου | Python και Docling για τα PDF, μαζί με εξαγωγή κειμένου από HTML και PPTX κατά το build. |
| Εμφάνιση απαντήσεων | CommonMark, ελεγχόμενος DOM renderer, KaTeX και fflate που φορτώνεται όταν χρειάζεται για τα αρχεία ZIP. |
| Επαλήθευση και tracing | Cloudflare Turnstile και LangSmith. |
Μοντέλα και Fallbacks
Η επιλογή διαδρομής και η παραγωγή απαντήσεων χρησιμοποιούν διαφορετικές αλυσίδες μοντέλων. Σε κάθε αλυσίδα, η σειρά είναι από το κύριο μοντέλο προς το τελευταίο fallback:
- Αποφάσεις:
Baseten Mammoth 1→Baseten Elephant 1→Inception Mercury Decide→TypeSafe Jev 1.14. - Planning και απαντήσεις:
NVIDIA Nemotron 3 Ultra 550B A55B→Google Gemma 4 31B IT→OpenRouter router→GLM 5.3 Flash. - Τίτλοι συνομιλιών:
NVIDIA Nemotron 3 Ultra 550B A55B, σε ανεξάρτητο background task.
Ένα timeout, ένα σφάλμα επικοινωνίας ή μια απάντηση που δεν ακολουθεί την απαιτούμενη δομή ενεργοποιεί το επόμενο fallback. Όλες οι προσπάθειες πρέπει να χωρέσουν στο συνολικό χρονικό όριο του αιτήματος και ελέγχονται με τις ίδιες απαιτήσεις πηγών και μορφής. Αν το μοντέλο επιστρέψει έγκυρη άρνηση, η διαδικασία ολοκληρώνεται εκεί.
Για κάθε απάντηση καταγράφεται το μοντέλο που χρησιμοποιήθηκε πραγματικά, ακόμη κι αν το επέλεξε ο router του OpenRouter. Οι κλήσεις για αποφάσεις και τίτλους καταγράφονται χωριστά, ώστε να είναι σαφές ποιο μοντέλο έκανε τι.
Ο τίτλος δημιουργείται και αποθηκεύεται ανεξάρτητα από την απάντηση. Αν η κλήση αποτύχει, η αρχική ερώτηση παραμένει ως τίτλος. Αν ο επισκέπτης μετονομάσει στο μεταξύ τη συνομιλία, ο αυτόματος τίτλος δεν αντικαθιστά τη δική του επιλογή.
Προετοιμασία Περιεχομένου και Metadata
Στο corpus περιλαμβάνονται ελληνικές και αγγλικές σελίδες, βιογραφικά, PDF ερευνητικών εργασιών και projects, υλικό της διπλωματικής και παρουσιάσεις PPTX. Περιλαμβάνονται επίσης το workshop, οι ανασκοπήσεις των σεζόν της Formula, οι οδηγοί και οι σελίδες των πρωταθλημάτων. Πηγαίος κώδικας, αρχεία ZIP, credentials και συνομιλίες επισκεπτών δεν μπαίνουν στο index.
Από τις σελίδες HTML κρατάμε το κυρίως κείμενο και τους δημοσιευμένους συνδέσμους, αφαιρώντας scripts, μενού και στοιχεία χειρισμού. Το Docling εξάγει από τα PDF κείμενο, πίνακες και όσους μαθηματικούς τύπους αναγνωρίζει, διατηρώντας τη σελίδα προέλευσης. Στα PPTX διαβάζεται το ορατό κείμενο με τη σειρά των διαφανειών. Όλα αυτά γίνονται πριν από το deployment. Όταν φτάνει μια ερώτηση, η αναζήτηση δουλεύει πάνω στο ήδη επεξεργασμένο περιεχόμενο.
Το κείμενο χωρίζεται σε parent chunks και μικρότερα αποσπάσματα για embeddings. Τα μικρά αποσπάσματα δίνουν πιο στοχευμένες εισόδους στα embeddings, ενώ τα parent chunks κρατούν το ευρύτερο κείμενο που χρειάζεται για να γραφτεί η απάντηση. Κάθε γραμμή πίνακα συνοδεύεται από τις επικεφαλίδες των στηλών της, ώστε οι τιμές να παραμένουν κατανοητές και όταν ανακτηθούν μόνες τους. Τα διαγράμματα που υπάρχουν μόνο ως εικόνες μέσα στα έγγραφα δεν αναλύονται.
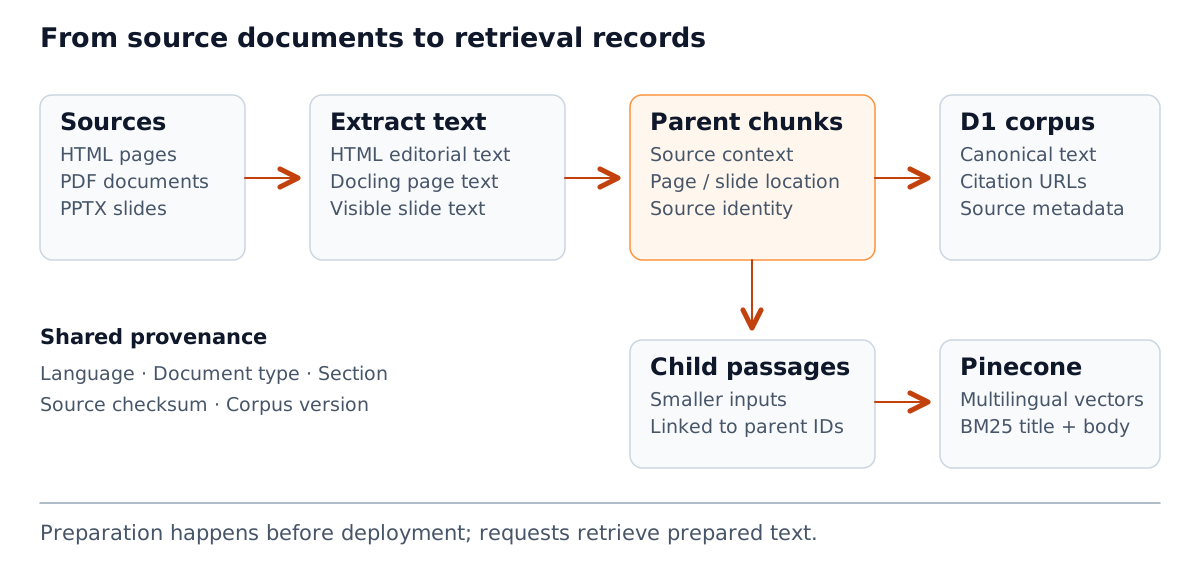
Στα metadata κάθε αποσπάσματος καταγράφονται η πηγή, το έγγραφο, η γλώσσα, ο τύπος και το format, οι θεματικές, οι επικεφαλίδες και, όπου υπάρχει, η σελίδα ή η διαφάνεια. Checksums, πληροφορίες για την εξαγωγή του κειμένου και εκδόσεις του corpus επιτρέπουν να εντοπιστεί από πού προήλθε κάθε εγγραφή. Ένα κοινό document ID συνδέει τη σελίδα μιας δημοσίευσης με το PDF και την παρουσίασή της. Η σύνδεση αυτή δεν σημαίνει ότι οι τρεις πηγές περιέχουν τις ίδιες πληροφορίες.
Αυτά τα metadata καθοδηγούν την επιλογή πηγών και τη σύνθεση του context. Για μια τεχνική λεπτομέρεια μιας εργασίας, το σύστημα μπορεί να αναζητήσει το PDF. Για μια γενική περιγραφή, μπορεί να αρκεί η σελίδα της δημοσίευσης. Παράλληλα, περιορίζονται τα διπλά αποτελέσματα από μεταφρασμένες σελίδες, χωρίς να αποκλείεται ένα αγγλικό paper επειδή η απάντηση θα δοθεί στα ελληνικά.
Η δομή του index ορίζεται σε ένα manifest, ενώ scripts αναλαμβάνουν τη δημιουργία και τον συγχρονισμό του. Κάθε έκδοση περιεχομένου ανεβαίνει σε ξεχωριστό namespace. Η αντίστοιχη έκδοση στην D1 ενεργοποιείται αφού ολοκληρωθεί το upload και περάσουν οι έλεγχοι ετοιμότητας. Τα σταθερά IDs επιτρέπουν επαναλαμβανόμενα uploads χωρίς διπλοεγγραφές. Το build του site προετοιμάζει τα αρχεία για το indexing, χωρίς να αλλάζει από μόνο του τους απομακρυσμένους indexes.
Υβριδική Αναζήτηση
Η Pinecone εκτελεί παράλληλα σημασιολογική αναζήτηση με embeddings και αναζήτηση όρων με BM25, εφαρμόζοντας τα ίδια φίλτρα πηγών. Τα πολυγλωσσικά embeddings βρίσκουν σχετικό περιεχόμενο ακόμη κι όταν η ερώτηση και το έγγραφο είναι σε διαφορετική γλώσσα. Το BM25 αναζητά τους όρους στους τίτλους και στο κείμενο των εγγράφων.
Τα scores των δύο αναζητήσεων δεν είναι άμεσα συγκρίσιμα. Το RRF συνδυάζει τις θέσεις των αποτελεσμάτων στις δύο κατατάξεις, αντί να προσθέτει τα scores. Αποσπάσματα που ανήκουν στο ίδιο parent chunk ομαδοποιούνται πριν επιλεγούν οι υποψήφιοι για το επόμενο στάδιο. Αν είναι ενεργό το reranking, το bge-reranker-v2-m3 αξιολογεί ξανά πόσο σχετικός είναι κάθε υποψήφιος με την ερώτηση.
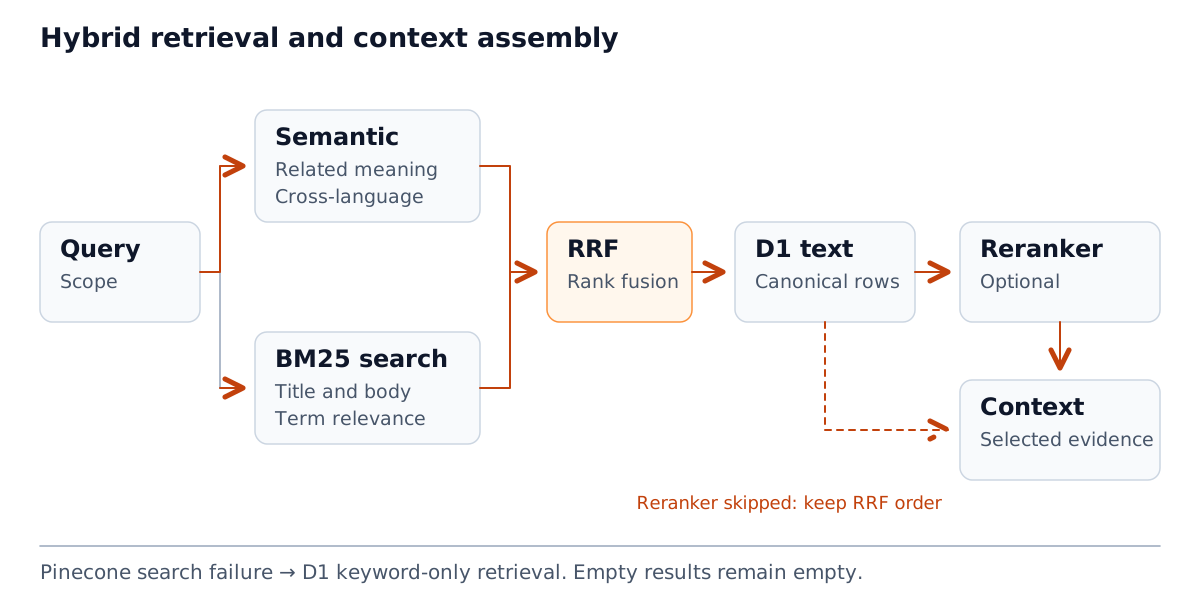
Με τα IDs των αποτελεσμάτων, ο server ανακτά το αντίστοιχο κείμενο από την D1, μαζί με τα ελεγμένα metadata του. Αυτό το κείμενο χρησιμοποιείται για την απάντηση, αντί να θεωρείται αξιόπιστο οποιοδήποτε κείμενο ή URL επιστρέψει η απομακρυσμένη αναζήτηση. Η σύνθεση του context λαμβάνει υπόψη τα ρυθμιζόμενα όρια υποψηφίων και μεγέθους κειμένου, την κάλυψη διαφορετικών πηγών και τις πηγές που έχει επιλέξει ο επισκέπτης.
Η συμπεριφορά εξαρτάται από το στάδιο που απέτυχε. Αν το reranking παραλειφθεί ή αποτύχει, διατηρείται η κατάταξη του RRF. Αν αποτύχει η αναζήτηση στην Pinecone, χρησιμοποιείται keyword search με D1 FTS5. Αν όμως η Pinecone λειτουργήσει κανονικά και δεν βρει αποτελέσματα, δεν ξεκινά δεύτερη αναζήτηση.
Πηγές και Ύφη Απάντησης
Με το @ ο επισκέπτης επιλέγει σελίδες ή αρχεία που υπάρχουν ήδη στο index. Η λίστα επιλογής αναζητά τίτλους, ονόματα αρχείων και περιεχόμενο, ενώ ο server ελέγχει τα IDs των επιλεγμένων πηγών. Αυτές οι επιλογές περιορίζουν πού θα γίνει η αναζήτηση και τι θα μπει στο context. Δεν δίνουν πρόσθετες οδηγίες στο μοντέλο. Αποθηκεύονται μαζί με την ερώτηση, ώστε το ιστορικό να διατηρεί και τις πηγές στις οποίες βασίστηκε.
Η γλώσσα και η persona ρυθμίζονται ανεξάρτητα. Οι οδηγίες για ελληνικά και αγγλικά καθορίζουν τη διατύπωση και την ορολογία. Η persona αλλάζει τον τόνο και την έκταση της απάντησης:
-
Απλό
Απλές, άμεσες εξηγήσεις, σαν κανονική συζήτηση.
-
Με χιούμορ
Χιούμορ και πιο παιχνιδιάρικη διατύπωση, πάντα σχετικά με το θέμα.
-
Μηχανικός αγώνα
Κοφτές φράσεις σαν επικοινωνία στον ασύρματο, με ξεκάθαρες προτεραιότητες και όσα χρειάζονται προσοχή.
-
Επίσημο
Επαγγελματικός τόνος, με σαφή διατύπωση και ακριβή ορολογία.
-
Στα γρήγορα
Σύντομη απάντηση που κρατά την ουσία.
Και τα πέντε ύφη ακολουθούν τους ίδιους περιορισμούς θέματος, τις ίδιες απαιτήσεις πηγών και τους ίδιους ελέγχους. Η επιλογή αποθηκεύεται για τη συνομιλία, ενώ κάθε απάντηση κρατά το ύφος με το οποίο γράφτηκε. Η γλώσσα των πηγών δεν δεσμεύει τη γλώσσα της απάντησης: ένα αγγλικό paper μπορεί να στηρίξει μια ελληνική απάντηση και μια ελληνική σελίδα μια αγγλική.
Το Chat Interface
Η σελίδα chat και το μικρό panel που ανοίγει πάνω από το site χρησιμοποιούν τον ίδιο TypeScript client και τον ίδιο μηχανισμό εμφάνισης απαντήσεων. Μετά τη συγκατάθεση για cookies, το sessionStorage κρατά πρόχειρα μηνύματα, επιλεγμένες πηγές, τις διαστάσεις του panel και την ενεργή συνομιλία. Το panel αλλάζει μέγεθος με ποντίκι ή πληκτρολόγιο και διατηρεί την κατάστασή του καθώς ο επισκέπτης αλλάζει σελίδες στην ίδια καρτέλα.
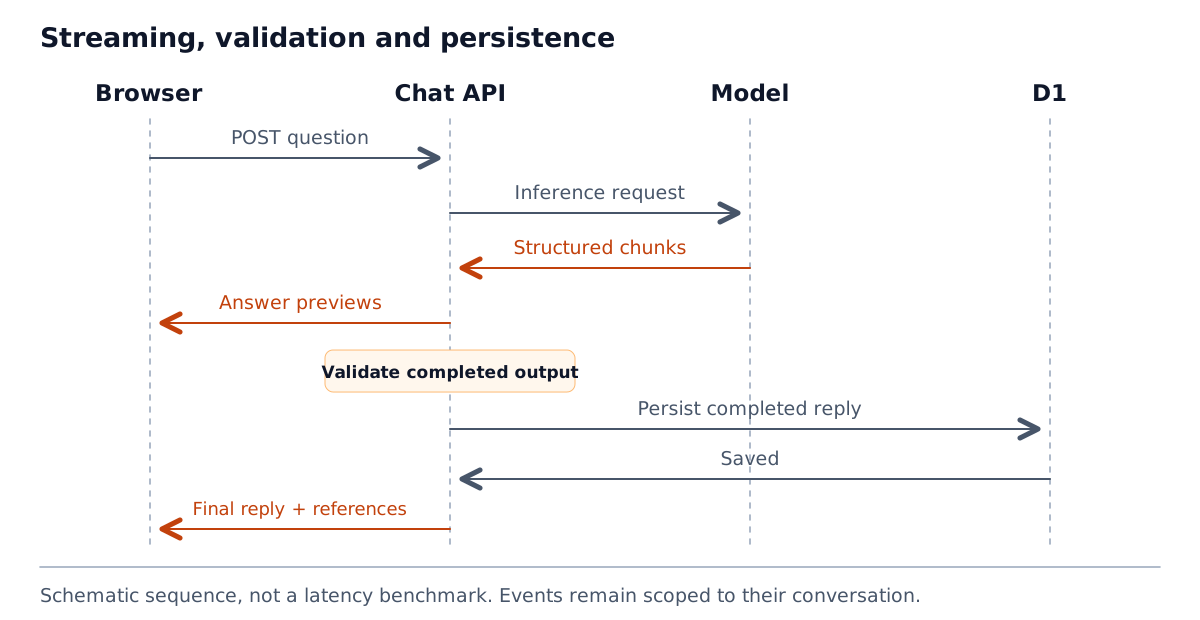
Η απάντηση μεταφέρεται σταδιακά μέσα από μια σύνδεση SSE μέσω POST, με δομημένα events. Ο client εμφανίζει μόνο το κείμενο της απάντησης που παράγεται, χωρίς να εκθέτει το JSON του provider ή το reasoning του μοντέλου. Αν μια προσπάθεια αποτύχει, το προσωρινό της κείμενο αφαιρείται πριν ξεκινήσει το fallback. Η τελική απάντηση αποστέλλεται αφού ελεγχθεί και αποθηκευτεί, μαζί με τις παραπομπές και το μοντέλο που τη συνέθεσε.
Κάθε απάντηση παραμένει συνδεδεμένη με τη συνομιλία της, ακόμη κι αν ο επισκέπτης έχει ανοίξει άλλη. Τα callbacks του stream ενημερώνουν το σωστό thread, οπότε μια καθυστερημένη απάντηση δεν μπορεί να εμφανιστεί σε διαφορετική συνομιλία. Η επεξεργασία που έχει ξεκινήσει στον server συνεχίζεται και μετά την αλλαγή προβολής. Η ανεξάρτητη δημιουργία τίτλων και τα σταθερά IDs μηνυμάτων διατηρούν τη σωστή αντιστοίχιση και όταν εκτελούνται πολλά αιτήματα παράλληλα.
Για την εμφάνιση, το κείμενο αναλύεται σε CommonMark syntax tree και ένας DOM builder αποδίδει μόνο τα στοιχεία που επιτρέπονται. Η ίδια διαδικασία εφαρμόζεται κατά το streaming και κατά την ανάγνωση αποθηκευμένων απαντήσεων: έμφαση, λίστες, επικεφαλίδες, παραθέματα, inline code και fenced blocks. Το KaTeX αποδίδει μαθηματικούς τύπους μέσα στο κείμενο ή σε ξεχωριστά blocks. Αν ένας τύπος δεν μπορεί να αποδοθεί, παραμένει ως απλό κείμενο.
Οι παραπομπές ανοίγουν σελίδες, PDF και διαφάνειες. Ελέγχονται τόσο τα Markdown links όσο και τα απλά URLs, ενώ πριν ανοίξει εξωτερικό site ζητείται επιβεβαίωση. Οι εικόνες προέρχονται μόνο από δημοσιευμένα αρχεία που συνδέονται με τις πηγές της απάντησης. Το κείμενο αντιγράφεται ως Markdown ή ως απλό κείμενο. Τα έγγραφα για λήψη επιλέγονται από τις ελεγμένες παραπομπές και το fflate φορτώνεται μόνο όταν χρειαστεί να δημιουργηθεί ZIP με πολλά αρχεία.
Ο επισκέπτης μπορεί να δημιουργεί, να μετονομάζει, να αρχειοθετεί, να επαναφέρει και να διαγράφει τις δικές του συνομιλίες. Ο client υποστηρίζει επίσης tour που μπορεί να ξεκινήσει ξανά, πλοήγηση με πληκτρολόγιο, ορατές ενδείξεις focus και reduced motion. Οι προτάσεις για επόμενες ερωτήσεις και οι σύνδεσμοι επικοινωνίας, όταν υπάρχουν, ελέγχονται μαζί με την υπόλοιπη απάντηση. Το interface δεν τους προσθέτει από μόνο του.
Έλεγχοι και Ιδιωτικότητα
Κάθε στάδιο ελέγχει τι παραλαμβάνει πριν προχωρήσει στο επόμενο: απόφαση, planning, ανάκτηση πηγών και τελική απάντηση. Οι έξοδοι των μοντέλων πρέπει να έχουν τη σωστή δομή. Οι επιλογές πηγών, τα IDs παραπομπών, οι σύνδεσμοι και οι εικόνες ελέγχονται με βάση τα δεδομένα του server. Στα prompts γίνεται σαφής διάκριση ανάμεσα στις οδηγίες της εφαρμογής και στο περιεχόμενο ερωτήσεων, ιστορικού, συνημμένων και πηγών, που αντιμετωπίζεται ως μη έμπιστο.
Το backend ελέγχει σε ποιες συνομιλίες έχει πρόσβαση κάθε browser και εφαρμόζει SQL με παραμέτρους, atomic ενημερώσεις των μετρητών χρήσης, χρονικά όρια και rate limits. Οι κλήσεις προς providers προετοιμάζονται στον server, χωρίς να στέλνονται credentials ή ιδιωτικές ρυθμίσεις στον browser. Το HTML που ενδέχεται να παράγει ένα μοντέλο δεν εισάγεται αυτούσιο στη σελίδα. Στο KaTeX είναι απενεργοποιημένες οι δυνατότητες trusted HTML και εντολών URL.
Το ιστορικό συνδέεται με μια ανώνυμη συνεδρία browser. Στην D1 αποθηκεύονται τα hashes των tokens που επιβεβαιώνουν την πρόσβαση στις συνομιλίες. Η αποθήκευση και οι κλήσεις προς providers ξεκινούν μόνο μετά τη συγκατάθεση για cookies. Αν αυτή ανακληθεί, η πρόσβαση στο chat απενεργοποιείται και η αλλαγή μεταφέρεται στις υπόλοιπες καρτέλες. Το ιστορικό λήγει αυτόματα, ενώ ο επισκέπτης μπορεί να το διαγράψει και νωρίτερα. Η διαγραφή από την εφαρμογή δεν αφαιρεί δεδομένα που έχουν ήδη επεξεργαστεί εξωτερικοί providers ή διαγνωστικά που διατηρούνται χωριστά.
Οι έλεγχοι αυτοί περιορίζουν τους κινδύνους, αλλά δεν εγγυώνται ότι κάθε απάντηση είναι σωστά τεκμηριωμένη ή ότι κάθε απόπειρα prompt injection θα αποτύχει. Μια έγκυρη παραπομπή δείχνει ποια πηγή χρησιμοποιήθηκε. Δεν αποδεικνύει από μόνη της ότι η πηγή στηρίζει κάθε πρόταση της απάντησης.
Observability
Στο LangSmith υπάρχουν ξεχωριστά projects για development και production. Κάθε μήνυμα αντιστοιχεί σε ένα root trace και τα μηνύματα της ίδιας συνομιλίας ομαδοποιούνται με το conversation ID. Τα επιμέρους spans καλύπτουν routing, planning, retrieval, rank fusion, reranking, παραγωγή απάντησης, αποθήκευση και τίτλο. Σε κάθε στάδιο καταγράφονται το μοντέλο, οι χρόνοι, οι κατηγορίες σφαλμάτων και όσα στοιχεία χρήσης είναι διαθέσιμα.
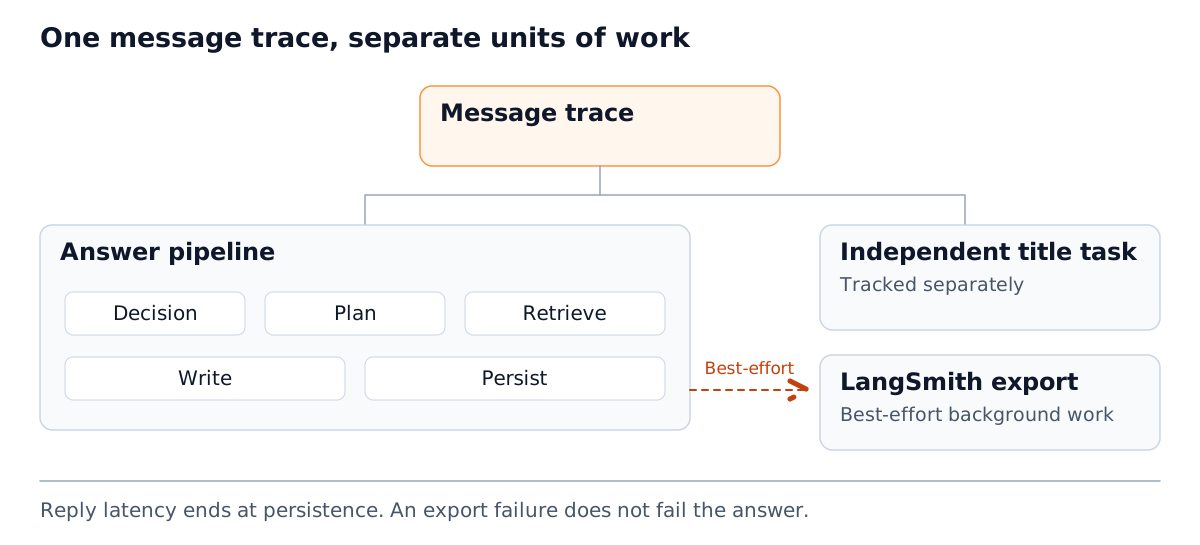
Ο χρόνος μετριέται σε τρία σημεία: όταν φτάσει το πρώτο κείμενο της απάντησης, όταν αποθηκευτεί η ολοκληρωμένη απάντηση και όταν τελειώσουν οι εργασίες στο background. Η δημιουργία τίτλου και η αποστολή των traces δεν προσμετρώνται στον χρόνο μέχρι την αποθήκευση της απάντησης. Έτσι φαίνεται πόσο περιμένει ο επισκέπτης για την απάντησή του, ανεξάρτητα από τις παράλληλες εργασίες.
Το LangSmith παραμένει ελαφριά, best-effort εξάρτηση. Το SDK φορτώνεται μόνο όταν είναι ενεργό το tracing. Η αποστολή των traces γίνεται στο background, με συγκεκριμένα όρια, και εγκαταλείπεται αν αποτύχει. Προβλήματα στη μετατροπή των δεδομένων, στην εκκίνηση της εργασίας ή στην επικοινωνία δεν εμποδίζουν την απάντηση. Η καταγραφή περιεχομένου και το sampling είναι ρυθμιζόμενα. Ευαίσθητα στοιχεία αποκρύπτονται, ενώ πλήρη prompts, κείμενα πηγών, credentials, ownership tokens και ιδιωτικό server context εξαιρούνται από την καταγραφή.
Αξιολόγηση
Η αξιολόγηση εξετάζει χωριστά αν επιλέχθηκε η σωστή διαδρομή, αν βρέθηκαν οι κατάλληλες πηγές, αν η απάντηση στηρίζεται σε αυτές και αν λειτουργεί σωστά η εφαρμογή. Τα automated regression tests καλύπτουν τη δομή των απαντήσεων, τους περιορισμούς πηγών, τη συγκατάθεση, την πρόσβαση στις συνομιλίες, τα όρια χρήσης με παράλληλα αιτήματα, το idempotency, το streaming και τις αποτυχίες εξαρτήσεων. Οι πραγματικές κλήσεις στα μοντέλα συμπληρώνουν αυτούς τους ελέγχους, αφού τα mocked responses δεν μπορούν να δείξουν πώς θα συμπεριφερθεί ένα μοντέλο.
Στις δοκιμές routing, το Jev ταξινόμησε σωστά 28 περιπτώσεις στα ελληνικά και τα αγγλικά. Περιλάμβαναν ερωτήσεις για το περιεχόμενο, χαιρετισμούς, ερωτήσεις που συνέχιζαν τη συζήτηση, ασαφή αιτήματα και ερωτήσεις εκτός θέματος. Το αποτέλεσμα αφορά το συγκεκριμένο μοντέλο και αυτές τις περιπτώσεις. Τα υπόλοιπα decision models δεν ήταν διαθέσιμα στη διάρκεια των δοκιμών, επομένως δεν ελέγχθηκε η ακρίβειά τους.
Για την αναζήτηση, συγκρίθηκαν τα αποτελέσματα των embeddings, του BM25 και του reranker με τις πηγές που περιμέναμε να βρεθούν. Οι ερωτήσεις αφορούσαν το workshop, την επαγγελματική πορεία, την έρευνα και τη Formula, και στις δύο γλώσσες. Οι γενικές ερωτήσεις για τη βαθμολογία του πρωταθλήματος έδειξαν ένα σημείο που χρειάζεται ακόμη δουλειά: ανασκοπήσεις σεζόν μπορούσαν να εμφανιστούν πάνω από τον οδηγό κανονισμών. Το σύστημα μπορεί να βρει το σωστό θέμα χωρίς να βρει την καλύτερη πηγή για τη λεπτομέρεια που ζητήθηκε.
Οι end-to-end δοκιμές εξέτασαν τη χρήση πηγών, τη συνέχεια της συζήτησης, τις πηγές που επέλεξε ο επισκέπτης, τις απαντήσεις και στις δύο γλώσσες και τη συνέπεια κάθε persona. Ξεχωριστές λειτουργικές δοκιμές ελέγχουν την αποθήκευση, τα model fallbacks και τη συνέχιση της απάντησης όταν δεν λειτουργεί το προαιρετικό tracing.